目次
Open 目次
はじめに
こんにちは。
以前、コードの匂いについての記事で、ドメイン上の制約を型そのものに持たせられるにもかかわらず、ロジックの途中で逐次的に条件判定しているコードに違和感がある、という話を書きました。 今回は、その中でも値オブジェクトについて少し整理してみようと思います。
値オブジェクトは、DDDを勉強すると比較的早い段階で出てくる概念ですよね。
メールアドレスをただの str として扱うのではなく EmailAddress にしたり、金額を int ではなく Money として扱ったりするものです。
この説明だけを見ると、プリミティブな値をわざわざクラスで包んでいるだけではないかと思うかもしれませんが、自分は値オブジェクトの価値はかなり大きいと思っています。特に重要なのは、その値が存在している時点で、そのドメインの不変条件を満たしていると考えられることです。
これができると、ビジネスロジックを書くときに、その値が正しいかどうかを毎回考えなくてよくなります。 単にクラスが一つ増えるという話ではなくて、コードを読むとき、変更するときに考えなければならないことを減らせるわけです。
値に関する知識がいろいろなところに散らばる
例えば、ユーザー名を扱う処理があるとします。 このサービスでは、ユーザー名は3文字以上30文字以下でなければならない、というルールがあるとしましょう。
値オブジェクトを使わずに実装すると、以下のようなコードになると思います。
def register_user(name: str):
    if not 3 <= len(name) <= 30:
        raise ValueError("ユーザー名は3文字以上30文字以下で指定してください")

    # ユーザーを作成する処理
これだけであれば、それほど問題には見えないと思います。 ただ、プロフィールの更新でもユーザー名を扱うのであれば、そちらにも同じチェックが必要になります。
def change_user_name(name: str):
    if not 3 <= len(name) <= 30:
        raise ValueError("ユーザー名は3文字以上30文字以下で指定してください")

    # ユーザー名を変更する処理
APIから登録するときにも、バッチから登録するときにも、管理画面から変更するときにも、このルールを守る必要が出てくるでしょう。 そうすると、本来書きたいユースケースの処理の中に、値そのものの妥当性を確認する処理が入り込んでくるんですよね。
当然、共通のバリデーション関数に切り出す、という方向で実装を進めていくでしょう。 ただ、その場合でも「この値を扱う前に、この関数を呼んでおく必要がある」ということを、呼び出し側が知っていなければなりません。 関数を呼び忘れた経路があれば、不正な値がそのまま流れてしまいます。
さらに、ユーザー名の制約が変わったときには、どこでチェックしているのか、どの経路ではチェックしていないのかを調べる必要が出てきます。 値に関する知識が、値を使う側に散らばっている状態です。
自分はこういった知識はその値自身に持たせた方が自然だと思っており、それが値オブジェクトの本質の一つだと思います。
生成できた時点で制約を満たしている状態を作る
同じルールを、UserName という値オブジェクトで表現してみます。
from dataclasses import dataclass


@dataclass(frozen=True)
class UserName:
    value: str

    def __post_init__(self):
        if not isinstance(self.value, str):
            raise TypeError("ユーザー名は文字列で指定してください")

        if not 3 <= len(self.value) <= 30:
raise ValueError("ユーザー名は3文字以上30文字以下で指定してください")こうしておくと、UserName の生成が成功した時点で、文字数の制約を満たしている状態になります。
name = UserName("akito")


def register_user(name: UserName):
    # ユーザー名の文字数をここで確認する必要はない
    ...
ユーザーを登録する処理は、ユーザーの登録について考えればよくなります。 この文字列はユーザー名として使ってよいのか、というところまで毎回戻って考慮する必要がありません。
ここで大事なのは、生成時にバリデーションするだけでは十分ではない、ということです。
生成した後に name.value = "a" と書き換えられてしまったら、せっかく守った制約が崩れてしまいますよね。
そのため、この例では frozen=True を指定して、通常のフィールド代入を禁止しています。値を変更したいときには、新しい UserName を生成します。
また、dataclass は値に基づく等価比較も生成するので、UserName("akito") == UserName("akito") は True になります。
識別子によって同一性を判断するエンティティとは違い、値が同じであれば同じものとして扱う、という値オブジェクトの性質も表現できます。
このあたりの挙動は、Pythonの公式ドキュメントにも記載されているので確認してみてください。
ただし、Pythonの型注釈は実行時に引数の型を強制するものではありません。
UserName と注釈を書けば、それだけで文字列の受け渡しを防げるわけではないので、型チェックを行い、入力やDBからの復元時にきちんと値オブジェクトを生成する設計が前提になります。
重要なのは、クラスを用意すること自体ではなくて、生成経路と生成後の操作を含めて、不変条件を守れる状態にすることです。
プリミティブな型だけでは値の意味が分からない
もう一つ、値オブジェクトを使う理由として大きいのが、値の意味をコードに表現できることです。
例えば、以下のような関数があったとします。
def calculate(price: int):
    ...
price なので金額らしいことは分かりますが、円なのかドルなのか、税込なのか税抜なのかは分かりません。
結局、その関数の実装や呼び出し元を見に行かないと、どう扱えばよい値なのか判断できないわけです。
Money という型にして、金額と通貨を一緒に持たせれば、少なくとも通貨を無視して計算することを防ぐ設計にできます。
税込と税抜の区別も必要なドメインであれば、それを別の型や明示的な操作として表現することも考えられます。
もちろん、Money という名前を付けるだけですべて分かるわけではなくて、その型にどの知識を持たせるかが重要です。
距離も同じですね。
ただの float で扱っていると、それがメートルなのかフィートなのかは、変数名やコメントを頼りに読み取る必要があります。
Meter や Foot として型を分け、変換処理を明示すれば、単位の違いをコードの上で表現できます。
単位の取り違えは現実のシステムでも重大な問題になっています。 有名な例としては、NASAがヤードポンド法単位からメートル法への変換が行われなかったことによる航法上の誤りで失敗した件がありますよね。

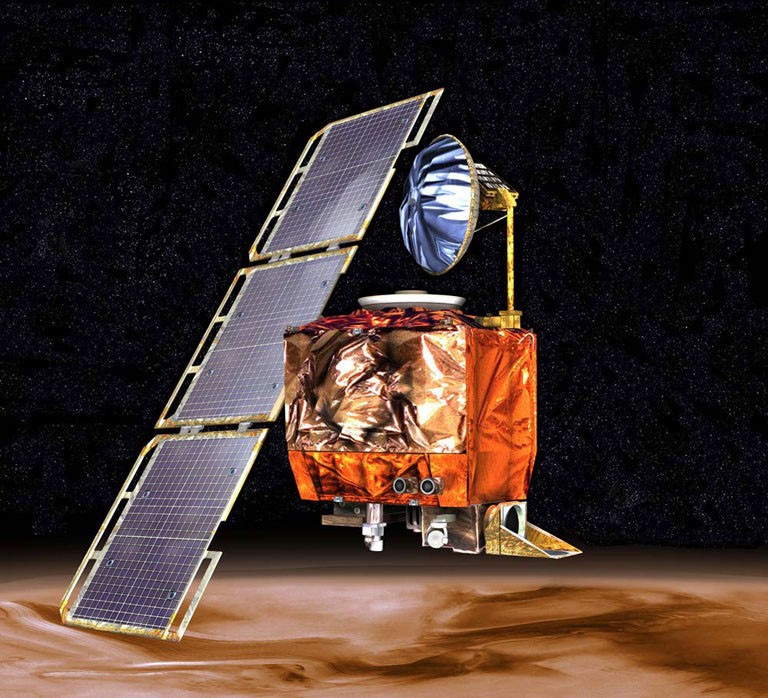
型を分ければこうした事故を必ず防げる、という話ではありませんが、単位の違いを明示し、異なる単位同士の演算をどう扱うかを型の中で決められることには意味があると思います。
str についても、表現できる値の範囲が広すぎるという問題があります。
メールアドレスもユーザー名も、SQLの断片のようなものも、型としてはすべて文字列です。
それをドメインの奥までそのまま持ち回るよりも、EmailAddress や UserName に変換して、扱ってよい値の範囲を絞った方が、読む側も実装する側も考えやすくなります。
もちろん、値オブジェクトはSQLインジェクション対策の代わりにはなりません。SQLを実行するときには、パラメータ化クエリなどの対策が別に必要なので、値オブジェクト単体でセキュリティを守れるわけではありません。 ただ、ドメインの中であり得る値に早い段階で絞っておくことで、それ以降の処理が扱う状態を減らせる、ということが、値オブジェクトの本質の一つではないかと思っています。
入力バリデーションで十分ではないのか
ここまでの話をすると、LaravelのForm RequestやPydanticでバリデーションすれば、それで十分ではないか、という話になると思います。
自分はそちらについては、その制約がどこの知識なのかが重要だと思っています。
例えば、リクエストに必要な項目が含まれているか・入力を文字列として受け取れるか、といったことは入口で確認する必要があります。 一方で「この事業の商品コードはこの形式でなければならない」「このサービスのユーザー名にはこの文字を使えない」「この用途の金額は0円未満になってはいけない」といったことは、ドメインのルールです。
文字数の上限も常に入力形式の都合とは限りません。 先ほどのユーザー名のように、サービスとして30文字までと決めているのであれば、それはドメイン側でも守るべき制約になります。 同じチェックに見えても、なぜその制約があるのかによって、責務の置き場所は変わるわけです。
これをAPIの入力バリデーションにしか書いていないと、バッチやCLI、別のユースケースから呼び出されたときに、制約を通らない可能性がありますよね。 今はAPIからしか呼ばれないとしても、将来もそうとは限りません。
なので自分としては、入口では入力として受け付けられるかを確認し、ドメインの不変条件は値オブジェクトでも守る、という設計が自然だと思っています。 利用者に複数の入力エラーをまとめて返すために入口でチェックすることと、ドメインに不正な値を存在させないことは、それぞれ目的があるからです。
ただ、あらゆるルールを値オブジェクトに入れるわけではありません。
例えばメールアドレスの重複確認には、他のユーザーの情報が必要です。形式として妥当な EmailAddress が生成できても、そのアドレスで登録してよいかどうかは別に判断する必要があります。
値そのものの不変条件と、他の状態との関係で決まる業務上の条件は分けて考える必要がありますね。
不正な値はできるだけ早い段階で止める
個人的には、不正な状態を検知したら、できるだけ早い段階で処理を止めた方がいいと思っています。
name = UserName(request.name)この時点でユーザー名として成立しないのであれば、その値を後続の処理に流す必要はありません。 この例では例外を送出していますが、生成結果を成功と失敗に分けて返す設計でもよいと思います。 どちらにしても、不正な値を持った値オブジェクトを生成しないことが重要です。
Webアプリケーションであれば、その失敗をアプリケーションの境界でHTTPエラーに変換します。 FastAPIやLaravelの例外ハンドリングの仕組みを利用して、ドメイン側のエラーを適切なステータスコードとレスポンスに対応付ける形です。 ドメインで送出した例外が自動的に入力エラーとして扱われるとは限らないので、そこは明示的に変換する必要があります。
ドメイン側ではその値が成立するかどうかを判断する一方で、HTTPでどう返すかは外側で判断する。 この分離ができていれば、同じドメインロジックをバッチから呼び出す場合にもHTTPの都合を持ち込まずに済み、責務の分離を実現できると思います。
クラスが増えることは問題?
値オブジェクトを使うとクラスが増えるので、複雑になるのではないかという話もあると思います。
僕自身は、クラスが増えること自体はそこまで問題だと思っていません。 クラスが少なくても、一つのクラスに大量の責務が集まっていたり、値の制約がいろいろな場所に散らばっていたりすれば、そちらの方が読むのは大変です。 ファイルの数よりも、変更するときにどれだけのことを頭に入れなければならないか、という認知負荷の方が重要だと思っています。
ただ、何でも値オブジェクトにすればいいとは考えていません。 その値にどのようなドメイン上の意味があるのか、何を守りたいのかが曖昧なままですべての文字列や数値をクラスで包んでも、扱う型が増えるだけになってしまいます。
型として表現することで、どの知識がまとまって何を考えなくてよくなるのかを説明できるかどうかが、一つの判断基準になると思っています。
既存システムにはそのまま入れられないことがある
そして、実際に導入するときに難しくなるのが、既存データとの関係です。
更新系の処理であれば、値オブジェクトは比較的使いやすいと思っています。 ユーザー作成や商品作成、プロフィール更新などで、入力を最初に値オブジェクトへ変換し、不正であればそこで止めるような処理ですね。 生成できた値を使って処理を進めれば、新しく保存する値については、その制約を守れます。
一方で、レガシーシステムのリプレイスでは、既存DBに現在のドメインルールでは許されない値が入っていることがあります。 以前は別のルールだったのかもしれませんし、過去にバリデーションを通らない経路から保存されてしまったのかもしれません。
その状態でDBから取得した値をすべて厳密な値オブジェクトに変換すると、どうなるでしょうか?
name = UserName(row.name)既存のユーザー名が2文字であれば、この時点で例外になります。 一覧画面を表示したいだけなのに、一件の古いデータが原因で参照処理そのものが失敗する可能性があるわけです。
設計としては制約を守りたい。でも、すでに存在しているデータがその制約を満たしていない。 これは実際のリプレイスで十分あり得る問題だと思いますし、実際にそのような問題に遭遇したことが何度もあります。
この場合、参照用のDTOなどで既存データをそのまま表示し、更新系では厳密な値オブジェクトを使う、という進め方も考えられますが、参照用の値をそのまま更新処理に流せば制約を迂回してしまうので、更新するところでは改めて値オブジェクトを生成する必要があります。
場合によっては、そもそも新しく決めた不変条件が、既存の業務を正しく表していないということもあります。 既存データが合わないからといって、すぐにデータ側が間違っていると判断するのも尚早になります。
以前のコードの匂いの記事でも書きましたが、設計はコードの見た目を綺麗にするためだけに行うものではなくて、今あるシステムや業務の状態を理解しながら、変更容易性の高い状態を作っていくことが必要です。 値オブジェクトについても、理想の形が分かったから一気に導入できるとは限りません。
とはいえ、システムを持続可能な状態にしていくために、最もハードルの低い選択肢として値オブジェクトは非常に有効な選択肢だと思います。
終わりに
値オブジェクトを使うと、ビジネスロジックを書く側はその値自身の妥当性を信頼して処理を書けるようになります。
UserName が渡ってきたのであれば文字数をもう一度確認する必要はありませんし、EmailAddress であれば、その型で定義した形式の制約を満たしていると考えられます。
値の意味が型に表現され、その値に関する知識が一箇所にまとまる。 そうすることで、ユースケース側に散らばっていた条件分岐が減り、仕様変更の際にもどこを変えればよいか分かりやすくなります。
自分は、値オブジェクトの一番大きな価値は、こうしてドメインの中で考えなければならない状態を減らせることだと思っています。 不正な値が来るかもしれない、ということをすべての処理で考え続けるのではなく、その値を生成するところで制約を守る。 その上で、内側では本来実現したいビジネスロジックに集中できるようにする。
値オブジェクトというとDDDのパターンとして覚えがちですが、なぜ使うのか、何が楽になるのかまで考えると、普段の設計にも取り入れやすくなるのではないでしょうか。
まずは値オブジェクトという選択肢を第一候補にして、自身のシステムのリファクタリングに取り入れる、ということを考えてみてください。